遅めの夏休みの工作として、Claude Codeと一緒に対になる2本のセキュリティツールを 作った。攻撃側の PownForge(許可されたラボ環境向けのモジュール型診断CLI)と、 防御側の RiskForge(脆弱性・エクスポージャー管理プラットフォーム)。
ツール自体の機能紹介は README に譲るとして、ここでは「AIエージェントに 大きめのコードベースを任せるとき、何を先に決めておくと安全か」、そして 「それでも実機でしか踏めなかったバグはどこに出たか」という、作りながら 学んだことをまとめておく。
AIエージェントに何をさせるかは、最初にAGENTS.mdで決めておく#
両リポジトリには、Claude Code のようなAIエージェント向けの運用ルールを
まとめた AGENTS.md を置いている。PownForge側の AGENTS.md には、
たとえばこんな制約を書いた。
config/targets.yamlに登録されていない対象へスキャンを実行するコードを 書かない・提案しない- 対象を登録できる経路は
pownforge target add/pownforge lab add/ Web API に限定する。いずれも最終的にScopePolicy.add_target()を通る ため、これ以外の独自の登録経路を追加しない core/policy.pyのスコープ検証ロジックを弱める変更は、ユーザーに 明示的に確認を取ってから行う- スキャン範囲を自動的に拡大する機能を、ユーザーの明示的な依頼なしに 実装しない
ScopePolicy.authorize()が拒否したスキャン実行の試みは、AuditStoreへ必ず記録する。この記録経路を無効化・迂回する変更を 提案しない
コミットまわりも同様に縛ってある。1コミット1関心事、コミットは
ユーザーから明示的に依頼されたときのみ作成、pre-commit相当のチェックが
失敗したら --no-verify で回避せず直す、秘密情報を含む可能性のある
ファイルはコミットに含めない、といった項目を並べている。
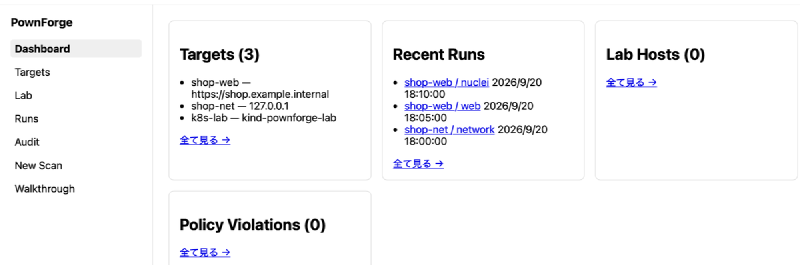
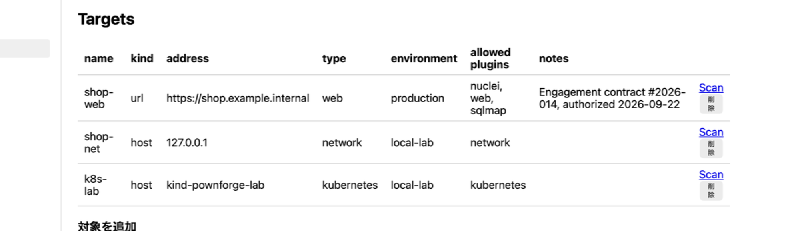
実際、Web UI の Target 一覧を見ると allowed-plugins や notes
(エンゲージメント契約番号)が対象ごとに紐づいていて、これが
ScopePolicy の検証対象そのものになっている。
これはPownForge固有の話ではなく、RiskForge側の AGENTS.md にも
(ドメインモデルの設計方針や、自動修復をデフォルトで拒否するポリシーなど)
同種の縛りが並んでいる。AIエージェントは指示されればいくらでも機能を
足そうとしてくるので、「作れるかどうか」ではなく「作っていいかどうか」の
線を先にドキュメントへ落としておく、というのが今回一番効いたやり方
だったと思う。
だから、PownForgeとRiskForgeはまだ繋がっていない#
PownForge側の AGENTS.md には、RiskForgeとの関係についてこう書いた。
[RiskForge]は、PownForgeと対になる防御側(Vulnerability & Exposure Management)の姉妹プロジェクトです(別リポジトリ)。連携の設計制約は RiskForge側の
AGENTS.md「20A. PownForge Integration」章が正本で (中略)連携自体は両プロジェクトとも未実装(RiskForge側のPhase 5待ち) です。ユーザーから明示的な依頼がない限り、RiskForge向けの専用出力 形式・エクスポートAPI・実行経路を先行実装しないでください。
つまり、繋ぎ方の設計はもう決めてあるのに、実装はあえて封印してある。
RiskForge側の AGENTS.md 20A章には、全体の関係をこう書いた。
PownForge
     │
     │ Finding / Evidence
     ▼
RiskForge
     │
     │ Remediation
     ▼
Target Asset
     │
     │ Verification
     ▼
RiskForge
PownForgeの診断結果は、RiskForgeのFindingとして直接取り込まない。 必ず一段クッションを挟む設計にしてある。
PownForge
  ↓
RawFinding
  ↓
Normalizer
  ↓
Matcher
  ↓
Finding- PownForge専用の特別経路を作らない
- PownForgeの出力形式をドメインモデルに漏らさない
- PownForgeのFindingを、そのままRiskForgeのFindingとして扱わない
責務分離もはっきり書いてある。「PownForge = 発見・検証のための攻撃側の 能力」「RiskForge = 是正の計画・承認・実行管理・検証結果の記録」。 PownForgeはRemediationを実行しないし、RiskForgeは攻撃的なテストを Remediationの一部として実行しない。
唯一の例外が、是正後に同じ診断を再実行して「もう成立しない」ことを
確かめる scanner_rescan というVerification手法で、これも次のように
かなり重めの手続きを必須にしている。
- 対象Assetと実行範囲のallowlist
- 承認と実行の分離
- productionではDry Runと承認を必須とする
- 実行内容をAudit Logに記録する
- 実行権限をScanner権限・Remediation権限とは別に分離する
防御側から攻撃系ツールを起動する、という一番危ういところだけ先に 細かく縛っておいて、それ以外の連携コードはPhase 5まで書かない。 「設計は先に固めるが、実装はあえて後回しにする」というのを、 AIエージェントに対しても人間に対しても同じドキュメントで宣言して おくのが、今のところ一番揺れない運用の仕方だと感じている。
実機でしか踏めなかったバグたち#
だからといって、AIに厳格なルールを渡しておけば安全というわけでも ない。ルールが縛るのは「やっていいこと/いけないこと」の線引きで、 「意図通りに動いているか」は結局実機で確かめるしかなかった。
hostrule系NSEスクリプトの結果が丸ごと消えていた
vulncheckプラグインは、nmapのvuln/safe分類スクリプトを許可リスト方式で
実行するのだが、 smb-vuln-ms17-010 のようなhostrule系スクリプトは、
nmap XMLの <port> 配下ではなく <hostscript> 配下に結果を返す。
XMLパーサーは <port> 配下の <script> しか走査していなかったので、
スクリプトは実際に実行され結果も出力されているのに、
output.results が常に空になっていた。Metasploitable2ラボ対象に
http-vuln-cve2011-3192 と smb-vuln-ms17-010 を実行して初めて
見つかったバグで、 <hostscript>/<script> も走査するよう直した。
ラボの攻撃対象コンテナが起動直後に落ちる
MetasploitableやOWASP BWAは公式にはVirtualBox/VMware用のVMイメージで
配布されていて、PownForgeが扱えるDockerイメージではない。実際に動く
Docker代替( tleemcjr/metasploitable2 など)を使ったのだが、
「サービス起動後にbashで居座る」CMDを持つイメージは、
docker run -d 単体だと標準入力のEOFで即座に Exited(0) になる、
という実機でしか出ない挙動を踏んだ。 LabManager.add() に -i
(標準入力を開いたままにする)を追加して直した。
Vulhub実機検証で見つかった2件
Vulhubの実チェックアウトを対象にlog4j(CVE-2021-44228)で実機 スモークテストをした際、その場で2件のバグが見つかった。
- Vulhub自身のcompose fileはポートをホストIP無しで公開しており
(例
"8983:8983")、これは*:8983(同一LAN上の他端末からも 到達可能)にbindされる。「隔離ラボホストでのみ実行する」という 前提をPownForge自身が無自覚に壊しうるため、ポートを常に127.0.0.1へ強制した一時compose fileに対してupを実行する よう修正した --registerがポートを非決定的に選んでいた。docker compose psが返す順序はcompose file記載順と一致しないため(log4jシナリオは Solr管理画面の8983を先に書いているが、psは先に5005を返した)、 意図しないポート(JDWPデバッグポート)を対象として登録して しまっていた。published_portsを常にcompose file自身の宣言順に 揃えるよう修正した
初心者ユーザーとして一通り触ってみたら4つ詰まった
init → lab add → scan → analyze → walkthrough → report →
result import → engagement add まで初心者のつもりで一通り実行して
みたところ、4件の詰まりどころが出てきた。
- scan完了メッセージがtool側のstderr出力を無視していた。nmapはDNS 解決失敗でも「0 hosts up」で終了コード0を返すため、 「completed (exit=0)」だけ見ると成功したように誤解する。stderrが 非空の場合に注意喚起の一行を追加した
analyze/walkthrough generateがDockerランタイム経由では 動かない(llm CLI未同梱、ラボネットワークが--internalで外部 到達不可)ことがどこにも書かれていなかった。handbookとREADMEに 明記したpownforge target removeがCLIに存在しなかった。core/policy.pyのremove_target()はあり、Web APIにもDELETE /api/targets/{name}があるのに、CLIだけ欠けていた。新設し、targetのallowed-pluginsを変更したい場合は remove→add し直すのが正規手順であることを ヘルプ文言に明記した
いずれのバグも、モックのXML/JSONを使うユニットテストだけでは 検出できなかったもので、実際の対象・実際のツールに対して動かして 初めて表に出てきた。AGENTS.mdでスコープや連携範囲をどれだけ厳密に 縛っても、その内側で「ちゃんと動いているか」は結局実機で確認する しかない、というのが今回の夏休み工作の実感だった。